
 English
 Français
 Español
 Deutsch
 Português
 Italiano
 العربية
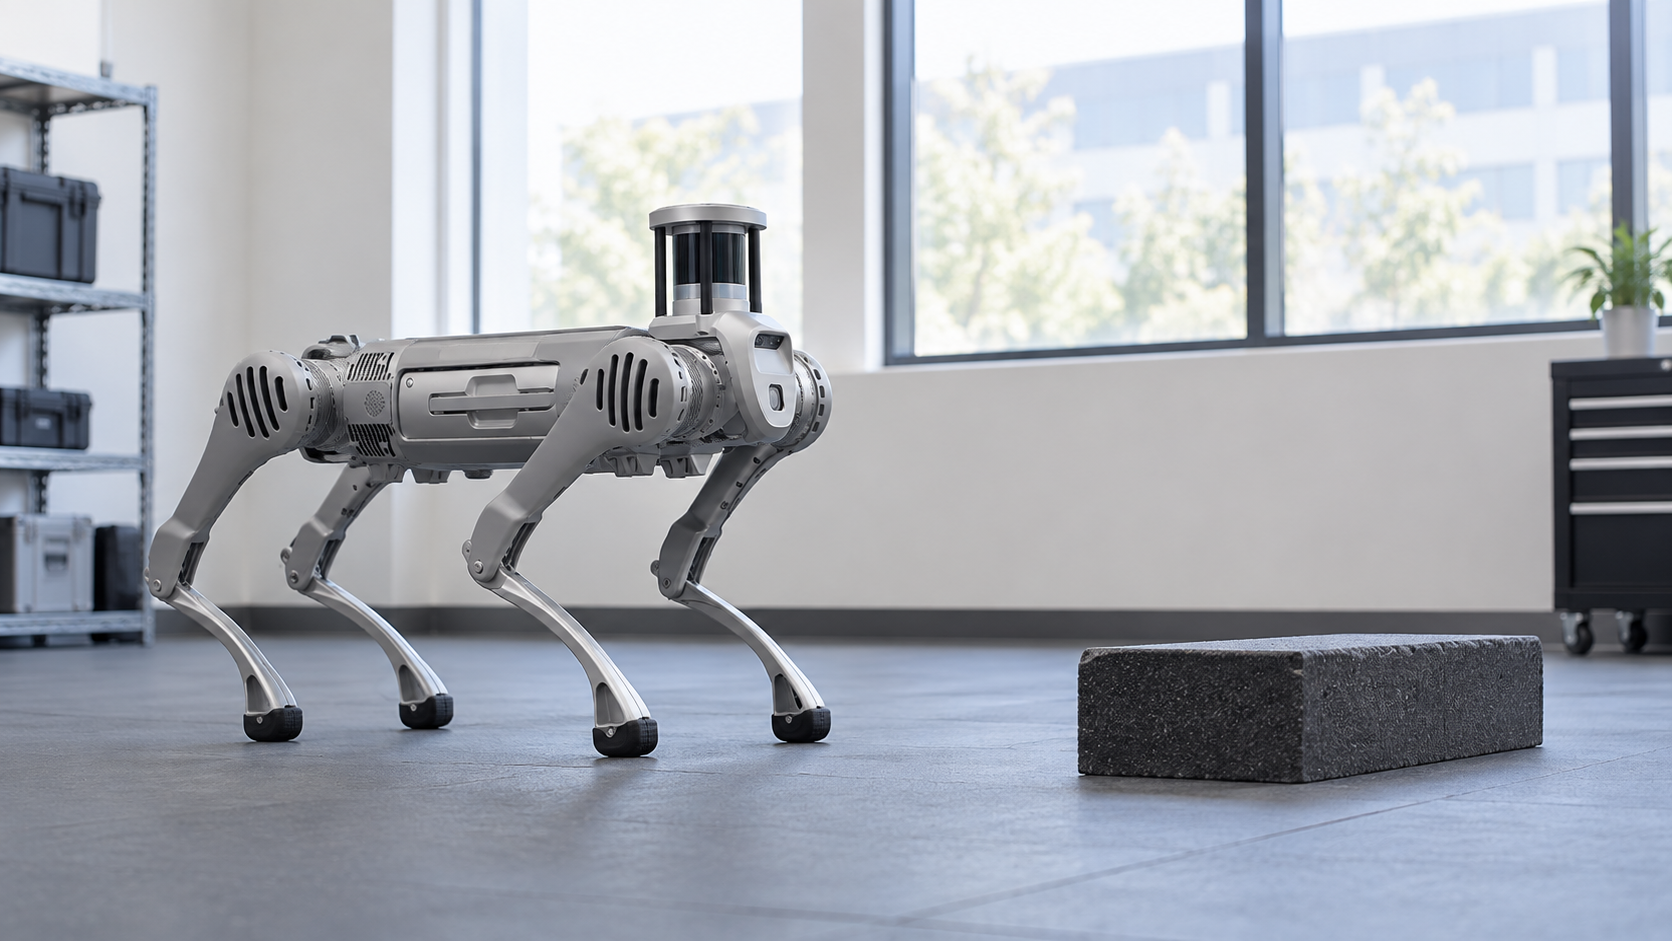
Ein Roboter kann eine Aufgabe tausendfach ausführen, ohne einen virtuellen Raum zu verlassen. Das ist ein nützlicher Gedanke hinter Physical-AI-Simulation: Software kann Entscheidungen mit Situationen konfrontieren, die sich mit echter Hardware nur langsam, teuer oder schwer wiederholen lassen.
Ein erfolgreicher virtueller Durchlauf lässt allerdings eine Frage offen: Was wurde genau getestet? Ein Roboter im simulierten Flur, eine 3D-Gebäudeansicht mit aktuellen Sensordaten und eine Automatisierung mit einer Mock-Antwort können alle wie ein Test digitaler Realität aussehen. Sie belegen sehr unterschiedliche Dinge.
Diese Unterscheidung macht das Thema verständlicher. Sie erklärt, wie Roboter vor der Bewegung lernen, wie sich Gebäudelogik vor dem Befehlsversand prüfen lässt und weshalb beides reale Tests nicht ersetzt. Eine überzeugende Animation ist nur dann nützlich, wenn sie zur Frage passt, die der Test beantworten soll.
Digital-Twin-Simulation: Was lässt sich in einem virtuellen Gebäude prüfen?
Ein digitales Gebäudemodell kann verschiedene Zwecke erfüllen. Es zeigt vielleicht Gerätepositionen und aktuelle Messungen. Es kann Bewegungen im Raum darstellen oder Berechnungen physikalischen Verhaltens ermöglichen. Derselbe Grundriss bedeutet nicht, dass die Modelle dieselben Informationen enthalten oder dieselben Fragen beantworten.
Eine aktuelle 3D-Ansicht verknüpft Informationen mit einem verständlichen Ort. Der gemeldete Türzustand erscheint an der richtigen Tür, Raumwerte im zugehörigen Raum. Ein großes Gelände wird so leichter lesbar als eine Liste unbekannter Sensoridentitäten. Der Nutzen liegt in der räumlichen Zuordnung der Beobachtungen, nicht in der Vorhersage jedes denkbaren Ereignisses.
Eine physikalische Simulation braucht mehr. Soll geklärt werden, ob ein Roboter eine Oberfläche überqueren oder ein Objekt handhaben kann, genügt die Geometrie nicht. Materialien, Kontaktverhalten, Bewegung sowie Roboter und Sensoren müssen gegebenenfalls geeignet modelliert werden. Welche Details nötig sind, hängt vom untersuchten Verhalten ab.
Daneben gibt es das Modell eines Softwareablaufs: Was passiert, wenn Informationen eintreffen? Es kann prüfen, ob ein Raumevent den richtigen Zweig auswählt oder ein nicht verfügbarer Roboter die vorgesehene Reaktion auslöst. Dafür werden möglicherweise Identitäten, Zeitstempel und realistische Antworten benötigt, aber keine fotorealistischen Bodentexturen oder simulierten Roboterbeine.
Diese Darstellungen können zum selben Projekt gehören, dürfen sich aber nicht unbemerkt ersetzen. Eine Tür, die im Dashboard ihre Farbe wechselt, beweist nicht, dass der Roboter sie öffnen kann. Ein virtuell durchfahrener Raum beweist nicht, dass eine reale Missionsanfrage die richtige Maschine erreicht. Jeder Test muss zu der Aussage passen, die daraus abgeleitet wird.
Robotersimulation: Bewegung vor der ersten echten Mission erproben
Robotersimulation schafft eine Umgebung für kontrollierte Situationen. Je nach Werkzeug enthält sie virtuelle Kameras, Objekte, Hindernisse und Bewegung. Entwickler wiederholen Bedingungen, verändern sie und vergleichen Ergebnisse, ohne jedes Mal einen physischen Versuchsaufbau umzugestalten.
Das ist besonders beim Lernen wertvoll. Ein System kann mittels Reinforcement Learning Aktionen im Hinblick auf ein definiertes Ziel erkunden. Andere Abläufe verwenden Demonstrationen, synthetische Beobachtungen oder bewerten eine vorhandene Strategie. Nicht jeder Roboter lernt gleich. Simulation ist ein Werkzeug innerhalb eines Entwicklungsprozesses, kein universelles Rezept für Intelligenz.
Variation ist ebenso wichtig wie Wiederholung. Wenn ein Roboter nur bei einer Objektposition und einer Beleuchtung funktioniert, sagt wiederholter Erfolg wenig über wechselnde Umgebungen aus. Virtuelle Szenen können unterschiedliche Anordnungen und Wahrnehmungen erzeugen. Entscheidend bleibt, ob diese Varianten tatsächliche Herausforderungen außerhalb des Simulators abbilden.
Ein Inspektionsroboter veranschaulicht das. Seine Testumgebung kann Flure unterschiedlicher Breite, wechselnde Hindernispositionen und veränderte Sensorbeobachtungen enthalten. Das Verhalten wird vor einem echten Versuch bewertet. Das ist eine andere Aufgabe als die Entscheidung, welches Gebäudeereignis überhaupt eine Inspektion anfordern soll.
Auch Fehler lassen sich teilweise leichter untersuchen. Wiederholungen mit gleichen Ausgangsbedingungen helfen, den Einfluss einer Änderung zu erkennen. In einem echten Gebäude haben sich zwischen Versuchen womöglich Menschen oder Gegenstände bewegt. Beide Umgebungen liefern Belege, aber ein kontrollierter virtueller Versuch kann Fragen isolieren, die sich physisch schwer trennen lassen.
Ein Simulator spiegelt trotzdem Entscheidungen seiner Entwickler wider. Was dargestellt, vereinfacht oder ausgelassen wird, beeinflusst die Bedeutung eines Erfolgs. Ein gutes Bewegungsmodell kann ein bestimmtes Sensorproblem unzureichend erfassen. Eine detaillierte Szene kann eine wichtige Wechselwirkung vergessen. Realismus muss für die Aufgabe relevant sein, nicht nur gut aussehen.
Sim-to-Real-Transfer: Warum Simulationserfolg erst der Anfang ist
Der Sim-to-Real-Gap bezeichnet die Differenz zwischen Modell und wirklicher Umgebung. Oberflächen, Objekte, Licht, Sensorik und Zeitverhalten können anders ausfallen. Das ist relevant, wenn ein gelerntes Verhalten von Details abhängt, die der Simulator ungenau oder überhaupt nicht abgebildet hat.
Ein Simulationserfolg ist deshalb ein Beleg mit begrenzter Reichweite. Er zeigt, dass das Verhalten unter den getesteten Modellbedingungen funktioniert hat. Er belegt weder die Vollständigkeit dieser Bedingungen noch, dass die Installation allen Annahmen entspricht. Der Übergang zur Realität ist ein weiterer Bewertungsschritt, nicht nur ein Dateiexport.
Ein virtueller Flur macht das deutlich. Seine Abmessungen können stimmen, während die reale Strecke reflektierende Oberflächen, ein vorübergehendes Hindernis oder eine anders reagierende Tür enthält. Manche Unterschiede lassen sich ergänzen. Andere werden erst in kontrollierten Praxistests entdeckt. Modell und reale Versuche können sich während des Projekts gegenseitig verbessern.
Das Prinzip gilt auch außerhalb der Bewegung. Ein simuliertes Gerät antwortet sofort, echte Hardware vielleicht verzögert oder gar nicht. Ein Netzwerk kann Meldungen doppelt oder verspätet liefern. Ein Test mit ausschließlich sauberen, pünktlichen Antworten belegt vor allem den Normalfall. Schwierigeres Verhalten der Installation bleibt damit ungeprüft.
Für ein Inspektionsprojekt entstehen Belege daher auf mehreren Ebenen. Robotertests behandeln Bewegung und Wahrnehmung. Integrationstests prüfen Missionsschnittstelle und Rückmeldungen. Ablaufprüfungen untersuchen den Weg vom Ereignis zum Auftrag. Eine reale Installation benötigt das passende Zusammenspiel, statt eine einzelne beeindruckende Vorführung als Beweis für alles zu verwenden.
Physical-AI-Simulation: Abläufe testen, ohne Geräte zu bewegen
Die Logik rund um eine physische Aufgabe lässt sich oft prüfen, bevor die Maschine verfügbar ist. Bewegungsevent, Raumkennung und Missionsantwort werden als Eingaben dargestellt. Anschließend lässt sich beobachten, welchen Entscheidungsweg die Software einschlägt. Dafür ist nicht zwingend ein 3D-Simulator erforderlich.
Beim beispielhaften Inspektionsablauf unterscheidet sich ein neues Ereignis im erwarteten Raum von einer alten, inzwischen irrelevanten Beobachtung. Ein nicht verfügbarer Roboter verlangt eine andere Reaktion als eine angenommene Mission. Wiederholte Meldungen dürfen nicht versehentlich Arbeit erzeugen, die nur einmal angefordert werden sollte. Das sind Betriebsfragen, keine Fragen zur Mechanik der Beine.
Kilos Physical-AI-Plattform unterstützt diesen Entwicklungsteil mit Geräteemulation und Regeldebugging. Emulierte Messungen liefern kontrollierte Eingaben. Debugging macht Zweige, Variablen und unterstützte Seiteneffekte untersuchbar. Getestet wird der Ablauf um das Gerät herum. Kilo wird dadurch nicht zu einer Physik-Engine für Roboterbewegung oder einer Trainingsplattform für Robotik-Grundmodelle.
Die Seiteneffektsteuerung benötigt besondere Aufmerksamkeit. Execute führt im Kilo-Debugger den echten Handler aus und ist zunächst ausgewählt. Skip überspringt die Aktion ohne Variablenänderung. Mock liefert eine Ersatzantwort zur Fortsetzung. Wer ohne reale Geräteaktion testen will, muss also ausdrücklich Skip oder Mock auswählen. Den Debugger zu öffnen isoliert die Hardware noch nicht.
Eine Mock-Antwort hilft bei Ergebnissen, die sich real nur schwer gezielt erzeugen lassen. Ein Test kann etwa Nichtverfügbarkeit vorgeben und die weitere Behandlung beobachten. Die Antwort muss aber zum tatsächlichen Schnittstellenvertrag passen. Erfundenen Feldern oder Statuswerten zu folgen würde eine Integration prüfen, die gar nicht existiert.
Wenn der Aufbau reale Geräte erhält, können passende Sensoren und Gateways über Kilo Electronics beschafft werden. Damit kommen neue Fragen hinzu: Trifft die Beobachtung aus der tatsächlichen Installation ein, ist ihr Zeitverhalten geeignet und wird die gewünschte Operation unterstützt? Der Testumfang wächst mit den benötigten Belegen, nicht bloß mit der Zahl gekaufter Geräte.
Physical-AI-Tests: Was Mock-Antworten nicht beweisen
Ein Mock zeigt, wie Software mit einer vorgegebenen Antwort umgeht. Er beweist nicht, dass ein Roboter den Raum erreicht, ein Sensor das gewünschte Ereignis erkennt oder Funk durch die Wände funktioniert. Das sind Eigenschaften realer Hardware und Umgebung. Diese Grenze verhindert, dass Softwareerfolg zur unbelegten physischen Behauptung wird.
Selbst das Wort Erfolg braucht Zusammenhang. Eine angenommene Mission genügt vielleicht, um den nächsten Softwarezweig zu testen, beweist aber keine abgeschlossene Inspektion. Die reale Integration kann spätere Zustände oder zusätzliche Beobachtungen bereitstellen. Tests müssen die vorhandenen Unterschiede abbilden, statt alles in einer optimistischen Antwort zusammenzufassen.
Fehlerfälle helfen, wenn sie an reale Entscheidungen anknüpfen. Was geschieht mit einer zu alten Beobachtung? Mit einem abgelehnten Befehl? Mit einer angenommenen Mission ohne Abschlussmeldung? Die Antwort braucht ein sichtbares Ergebnis und eine zuständige Person oder ein zuständiges System für offene Arbeit. Ein flüssiger Modelltext ersetzt dieses Verhalten nicht.
Versionierung verbindet den geprüften Entwurf mit der bereitgestellten Fassung. Kilo speichert Regelversionen und stellt einen verfügbaren früheren Stand als neuen Entwurf wieder her. Build und Deployment bleiben separate Schritte. Das bisherige Artefakt läuft bis zur Bereitstellung eines neuen Builds weiter. So lässt sich nachvollziehen, was tatsächlich veröffentlicht wird.
Die Wiederherstellung hat eine Grenze, die Simulation leicht verdeckt: Physische Vorgänge laufen nicht mit der Software rückwärts. Ein Roboter ist vielleicht bereits gefahren oder ein Gerät hat seinen Zustand verändert. Frühere Logik macht das nicht ungeschehen. Erforderliche Stornierungen oder Korrekturen hängen von tatsächlichen Gerätefähigkeiten und den Verfahren vor Ort ab.
Ein guter Testnachweis ist deshalb konkret. Er nennt Eingaben, simulierte Antworten, etwaige reale Seiteneffekte und die untersuchte Version. Das hilft mehr als die pauschale Aussage, ein System sei im digitalen Zwilling getestet worden. Andere Personen erkennen, was belegt ist und welche Prüfung noch fehlt.
Physical-AI-Simulation: Häufige Fragen
Ist jeder digitale Zwilling ein Simulator?
Nein. Er kann vor allem aktuelle Informationen einem dargestellten Objekt zuordnen. Simulation benötigt geeignete Modelle für das untersuchte Verhalten. Eine Gebäudeansicht und eine physikalische Testumgebung können beide nützlich sein und trotzdem andere Fragen beantworten.
Ersetzen Ablaufprüfungen Robotersimulation?
Nein. Ablaufprüfungen untersuchen Entscheidungen, Schnittstellenverhalten und kontrollierte Antworten. Robotersimulation behandelt Bewegung, Sensorik oder gelerntes Verhalten in einer Modellumgebung. Ein Projekt kann beides und anschließende Tests mit realen Geräten benötigen.
Macht ein Mock den ganzen Test automatisch ungefährlich?
Nur tatsächlich ersetzte Effekte sind simuliert. Andere Aktionen können real bleiben. Unterstützte Seiteneffektknoten in Kilo verlangen eine bewusste Wahl zwischen Execute, Skip und Mock; Execute ist vorausgewählt. Die Testgrenze muss vor dem Lauf klar sein.
Warum lohnt sich dieser Aufwand?
Virtuelle Tests machen Entscheidungen untersuchbar und schwierige Fälle wiederholbar, bevor sich ein Betrieb darauf verlässt. Ihr Wert steigt mit klaren Grenzen. Der Roboter übt Bewegung, die Software übt Ergebnisbehandlung und reale Tests konzentrieren sich auf das, was keines der Modelle bisher belegt hat.